大型前端项目的国际化配置管理实践
之前写过一篇 将vite项目进行国际化改造的文章,里面简单介绍了一下简单项目的国际化落地方案。
国际化原理本身不复杂,但在大型前端项目、尤其是多客户定制的saas项目里面,国际化的工程化问题比技术问题要复杂很多。
假设要把一个按钮从“删除”改成“移除”,源码里只需要改几个字。但放进完整的国际化流程之后,还需要知道:它会不会生成新的词条?已有翻译怎么处理?公共组件里的文案有没有一起提取?后台改过的值会不会被下一次导入覆盖?用户已经打开的页面什么时候拿到更新?
本文总结一种大型前端项目中工程化维护国际化配置的方案。
这套国际化方案有几个直接影响日常维护的决策:静态和动态词条共用映射结构,源码保留中文,类型和命名空间参与 key 的生成,提取与构建保持一致,翻译独立维护。先把这些选择及其原因说明白,再看应用规模增长之后,为什么需要按应用拆分、缓存和版本更新。
文中的代码均为说明思路的伪代码,字段和编码格式使用通用示例。
词条管理
静态词条与动态词条
国际化词条本质上都是一个映射对象,维护一个 key 和真实要展示的内容。切换语言,就是根据当前语言找到对应的映射值。
// 示例:同一个 key 在不同语言下对应不同的展示内容
const messages = {
  'zh-CN': { 'save.success': '保存成功' },
  'en-US': { 'save.success': 'Saved successfully' },
};

const text = messages[currentLanguage]['save.success'];
按照词条的来源和维护方式,可以分为静态词条和动态词条。
静态词条声明在代码里,比如按钮名称、表单标签和“保存成功”这样的提示。构建时通过工程化工具提取,再由产品组织翻译,录入不同语言对应的映射值。开发者维护文案的使用位置和默认内容,产品及翻译人员维护各语言实际展示的内容。
动态词条由用户在界面上自己配置,比如标签名称及其不同语言的内容。保存时,根据业务对象的稳定标识关联 key,修改名称时更新映射值。它的维护跟随业务对象,不经过源码提取,也不能因为没有出现在提取结果中就删除。
两类词条的产生和维护方式不同,展示时都可以按 key 查询当前语言的内容。后续的资源加载和缓存也可以基于这份映射处理。
这里的“动态词条”指用户配置的文案。像“已选择 {count} 项”这样带变量的句子,句式仍然属于静态词条,变量在展示时填入。
客户自定义词条
SaaS 系统通常由多个客户共同使用,每个客户可能是一家公司或一个组织,内部又有多个用户账号。不同客户的业务叫法和使用习惯可能不同,因此可以开放词条配置,让客户自行调整界面上的文案。
比如系统默认把某个字段叫作“分组”,假设客户 A 习惯叫“团队”,客户 B 习惯叫“项目组”。它们可以为同一个 key 配置不同的展示内容,各自的用户进入系统后,看到所属客户配置的叫法。默认词条不需要跟着每个客户的习惯反复修改。
这时,同一个 key 在相同语言下,也可能对应不同的内容。可以保留一份系统默认映射,再为客户保存自定义映射;查询时优先使用当前客户配置的值,没有配置则回退到默认值。静态词条的默认翻译由产品维护,客户可以在此基础上调整;用户创建的动态词条也需要记录所属客户,避免影响其他客户的内容。
本文后面使用的“客户”,指这一层共享配置的公司或组织。同一客户下的用户可以共用这份配置;如果还允许每个账号设置自己的文案,则需要在客户配置之外,继续处理个人配置的优先级和隔离。
源码可读性
对于静态词条,在代码里直接写中文,比写一长串 key 更容易理解。阅读页面实现时,可以直接看到按钮、字段和消息分别展示什么;排查问题时,也可以拿页面上的中文搜索源码,定位到实际使用的位置。
// 伪代码:调用处保留使用语义和中文文案
translate('action', '保存');
translate('message', '确认删除“{name}”吗?', { name });
如果调用处只剩下一个生成后的编码,开发者就需要先去语言文件里查文案,再回到调用位置。源码保留中文,可以减少这层往返,搜索关键字和代码审查也更直接。
这个选择同时决定了分工:开发时维护可读的文案,工程化工具负责生成和同步 key。生成结果不需要人工写回源码。
词条类型
相同的中文,放在不同位置,对应的翻译可能不同。比如“保存”用在按钮上时表达一个动作,用在消息文本中时则需要结合消息含义翻译。仅凭中文相同就共用一个 key,会让这些场景只能使用同一份译文。
因此,action、message 这些类型需要参与 key 的生成。下面是使用相同中文的示意:
translate('action', '保存');
translate('message', '保存');
虽然文案哈希相同,但类型不同,最终 key 也不同:
ui.action.HASH_SAVE_TEXT
ui.message.HASH_SAVE_TEXT
翻译人员可以分别维护这两个 key 的内容。按钮上的词条按照动作翻译,消息里的词条按照消息的语气和含义翻译,两者不会互相覆盖。这样,类型在调用处表达使用语义,也在资源里保留了分别翻译的能力。
同一类型、相同文案可以复用一个 key。如果两个场景在同一类型下仍然需要不同译法,则需要进一步细分语义标识。类型提供了区分场景的依据,具体语义仍然需要通过使用位置或释义说明。
命名空间
微前端场景下,多个应用可能在同一个页面中运行,也可能把各自的词条导入同一个资源空间。如果只用“类型 + 文案哈希”生成 key,那么两个应用里相同类型、相同中文的词条就会得到同一个 key。
比如订单和库存两个应用都使用 translate('action', '保存')。它们的中文和类型相同,但可能由不同的产品分别维护翻译。共用一个 key,就意味着其中一个应用修改译文时,另一个应用也会受到影响。
因此,需要让命名空间参与词条身份,给不同应用维护的词条划定边界:
orders.action.HASH_SAVE_TEXT
inventory.action.HASH_SAVE_TEXT
这两个 key 可以分别维护译文。action、message 解决同一份中文在不同使用语义下的区分,命名空间则区分由哪个应用或公共模块维护。两者共同决定词条是否应该复用。
命名空间可以在工程配置中统一声明,由提取工具和构建插件读取。调用处仍然保留 translate('action', '保存'),不需要每一处都手动拼接应用名。提取和构建必须使用同一个命名空间,否则生成的资源与运行时查询无法对应。命名空间也应保持稳定,调整它会改变整组 key,涉及已有翻译的迁移。
公共组件可以使用独立的公共命名空间。确实需要统一维护的文案,由多个应用共同引用;属于各自业务的文案,保留在各自的命名空间里。公共组件词条的命名空间应当跟随定义它的模块,避免被不同应用引用后,又分别生成多份相同资源。
命名空间和按应用加载也需要区分:前者决定 key 属于哪个词条集合,后者决定当前需要下载哪些资源。一个应用可以同时加载公共命名空间和自身业务命名空间,不要求一个应用只能对应一个命名空间。客户下的定制译文,则继续在资源存储和缓存的作用域中隔离。
如果是词条独立存储、独立加载的单应用项目,可以先使用一个固定的默认命名空间,不必增加多命名空间的注册和切换机制。多个项目仅仅部署在一起,也不一定需要额外隔离;当它们会共享或合并词条资源、又需要独立维护翻译时,命名空间才成为需要明确管理的边界。
Key 生成规则
明确了调用形式之后,可以把 key 的生成规则归纳为:
命名空间.类型.文案哈希命名空间区分词条集合,类型区分使用语义,文案哈希让工具能够根据内容生成标识。在同一命名空间下,相同类型和文案得到相同 key,不需要逐条手工命名;移动文件也不会因为路径改变而生成新 key。
Babel 插件只需要完成下面几步。这里保留核心伪代码:
onTranslationCall(call) {
  const [type, text] = call.arguments;
  const key = `${namespace}.${type}.${md5(text)}`;

  collectTranslation({ key, text, type });
  replaceFirstArgument(call, key);
}
参与哈希的是中文文案,类型和命名空间另外拼接。构建时将第一个参数替换为生成后的 key,默认文案和插值参数保留。提取器和构建插件共用这套规则,保证翻译资源里的 key 与运行时查询的 key 一致。提取只处理内存中的 AST,源码中的中文保持可读。
采用文案哈希也有代价:默认文案变化会生成新 key。把“删除”改成“移除”,甚至调整标点,都可能产生新的翻译任务。旧译文不能直接视为新文案的译文,需要重新确认。
因此,修改源码中的默认文案,会进入新词条的维护流程;只修正某一种语言的译文,则更新已有 key 对应的映射值。两种修改需要分别处理。
翻译维护与导入
静态词条从代码提取出来之后,产品和翻译人员维护不同语言的映射值,再导入资源存储。这样,翻译调整有独立的维护入口,开发者也不需要在每次修改译文时改动调用代码。
为了保留已有翻译,提取结果需要和上一份翻译基线按 key 比较:已有 key 继续保留译文,新 key 进入翻译任务,不再使用的 key 进入待清理清单。默认中文没有变化、只是移动了文件时,也不会要求重新翻译。
提取范围需要覆盖页面和公共依赖,避免公共组件的词条漏出维护范围。输出时还应保留类型、使用位置和必要的释义,让翻译人员能够判断文案的实际含义。完整句式应保持可提取,变化的值通过参数传入,翻译时保留参数名并调整语序。
// 伪代码:完整句式进入翻译,count 在展示时填入
translate('message', '已选择 {count} 项', { count });
翻译维护完成后,导入需要确认资源归属和覆盖规则:写入哪个应用,是否允许覆盖人工调整的译文,空值如何处理,以及客户自定义内容是否受影响。动态词条通过界面保存,也需要保留相同的应用和语言归属。
词条清理同样受归属约束。假设 A、B 两个应用共用一条资源,A 不再引用它,B 仍在使用,仅凭 A 的提取结果就删除会影响 B。静态词条需要结合共同使用方和部署版本确认,动态词条则跟随业务对象清理。
这些维护规则共同保证:源码调整能形成明确的翻译任务,已有译文能够继续使用,导入和清理不会误改其他作用域的内容。
资源加载与缓存
词条较少时,可以直接加载当前语言的完整映射。随着页面、应用和公共组件增加,词条集合也会增长。如果每次进入系统都下载全部资源,用户当前用不到的内容也会参与传输和解析;重复进入同一个应用,又会重复下载相同的映射。
因此,这部分设计需要确定三件事:加载范围按什么拆分,缓存在哪些条件下可以复用,词条修改后如何让旧内容失效。
按应用拆分
用户进入一个应用,主要使用这个应用的页面和公共组件。按应用拆分语言包,就可以只加载当前语言的公共词条和应用词条,其他应用独有的内容留到使用时再加载。
比如订单和库存两个应用,进入订单页面时,只需要公共资源和订单资源。库存应用继续增加词条,不应让订单入口也下载这些内容。
// 伪代码:分别加载当前语言的公共包与应用包
const messages = mergeByPolicy(
  loadPack('common', language),
  loadPack(currentApplication, language),
);
这个划分同时保留了维护归属:公共组件的词条进入公共包,业务词条归入所属应用。公共包也需要控制范围,只有确实被共同使用的内容才放进去,否则它会逐渐变成所有入口都要加载的全量包。
应用是一个便于管理的拆分边界。如果单个应用仍然很大,可以继续按模块拆分,但需要承担更多依赖声明、加载时机和切换状态的管理成本。拆分粒度应当结合实际资源体积和使用范围决定。
缓存隔离
缓存能否共用,取决于两次加载是否会得到同一份映射。只用语言作为缓存 key 不够:相同语言下,应用的词条集合可能不同;前面提到的客户自定义配置,也会让不同客户得到不同的展示内容。
因此,在多个客户共用系统、同时包含多个应用的场景中,可以采用下面的隔离维度:
缓存作用域 = 客户 × 应用(或公共包)× 语言应用维度区分资源归属,语言维度区分译文,客户维度区分定制内容。切换其中任意一项,都需要读取对应作用域的资源,不能继续使用上一份映射。
用户是否需要作为额外维度,取决于内容是否存在用户差异。如果同一客户下的用户拿到相同资源,就可以复用缓存;如果允许用户级文案定制,就需要进一步隔离。缓存维度应当跟随影响展示内容的条件确定。
按作用域缓存,还能保留切换前已经下载的资源,回到原应用或语言时继续使用。过期和空间清理用于控制缓存的保留时间,资源是否需要更新则交给版本判断。
资源版本
静态词条导入、译文修正和动态词条配置,都可能改变最终展示的映射。因此,缓存的版本应该对应资源内容,不能只跟随前端代码的发布版本。即使没有重新发布页面,用户修改动态词条后也需要获取新内容。
服务端在对应作用域的资源发生变化时更新版本。客户端检查版本,相同就继续使用缓存,不同才获取新资源。下面省略具体接口约定,只保留这一决策:
// 伪代码:返回“版本一致”或同一份快照的版本与正文
const result = checkResourceVersion(scope, cached?.version);

if (result.changed) {
  const next = { version: result.version, messages: result.messages };
  saveCache(scope, next);
  applyMessages(scope, next.messages);
}
版本和正文需要来自同一份资源快照,并一起写入缓存。如果只推进版本,正文却没有保存成功,下一次检查就可能误以为本地已经拥有最新内容。公共包如果独立缓存,也需要独立检查版本,避免业务包没有变化时漏掉公共词条的更新。
缓存优先还是版本检查优先,则取决于实时性要求。允许短暂使用旧译文时,可以先恢复缓存,再异步检查;要求进入页面就使用最新内容时,则需要在展示前完成检查。前者减少等待,后者增加展示前的网络依赖,需要明确选择及其代价。
资源更新与界面刷新
用户刚保存的内容通常需要立即看到结果,可以主动刷新被修改的作用域,不必等待下一次进入应用。管理界面可能正在编辑另一个应用,因此刷新目标必须跟随被修改的资源。
// 伪代码:目标包含被修改资源的客户、应用和语言
saveTranslation(targetScope, values);
refreshResources(targetScope);
notifyViewsToReadAgain(targetScope);
这里需要处理资源与展示两个层面。缓存和内存映射更新后,已经存成普通字符串的标题、列配置和消息仍然可能保留旧值,需要让对应界面重新执行取词。
因此,翻译结果应当在展示需要时计算,语言或资源变化时重新读取。可以按资源作用域通知相关界面,避免每修改一个词条就刷新整个应用。同源页签也可以同步作用域和版本信息,由使用这份资源的页签更新展示。
切换应用、客户或语言期间,还要检查在途请求的结果是否属于当前上下文。旧作用域的资源可以保存在它自己的缓存中,但不能覆盖当前页面正在使用的映射。
按应用拆分控制加载范围,缓存复用已经下载的内容,资源版本决定何时更新,界面重新取词让修改实际展示出来。这几个边界需要相互对应,才能在词条增多之后继续控制加载量,并保留后台修改即时生效的能力。
完整流程
再回到开头那个按钮。采用文案哈希方案时,一次默认文案调整会产生新的 key。提取器收集主工程和依赖中的使用记录,与历史基线比较后生成翻译任务,再将维护完成的资源导入对应的应用空间。后台只修正译文时,可以沿用已有 key。动态词条由用户在界面上创建和维护,保存后形成对应的多语言映射,不经过源码提取。
应用规模增长之后,浏览器按当前语言和应用选择需要的资源,再通过缓存减少重复加载。词条发生变化时,版本检查、缓存更新和界面重新取词共同完成更新过程。
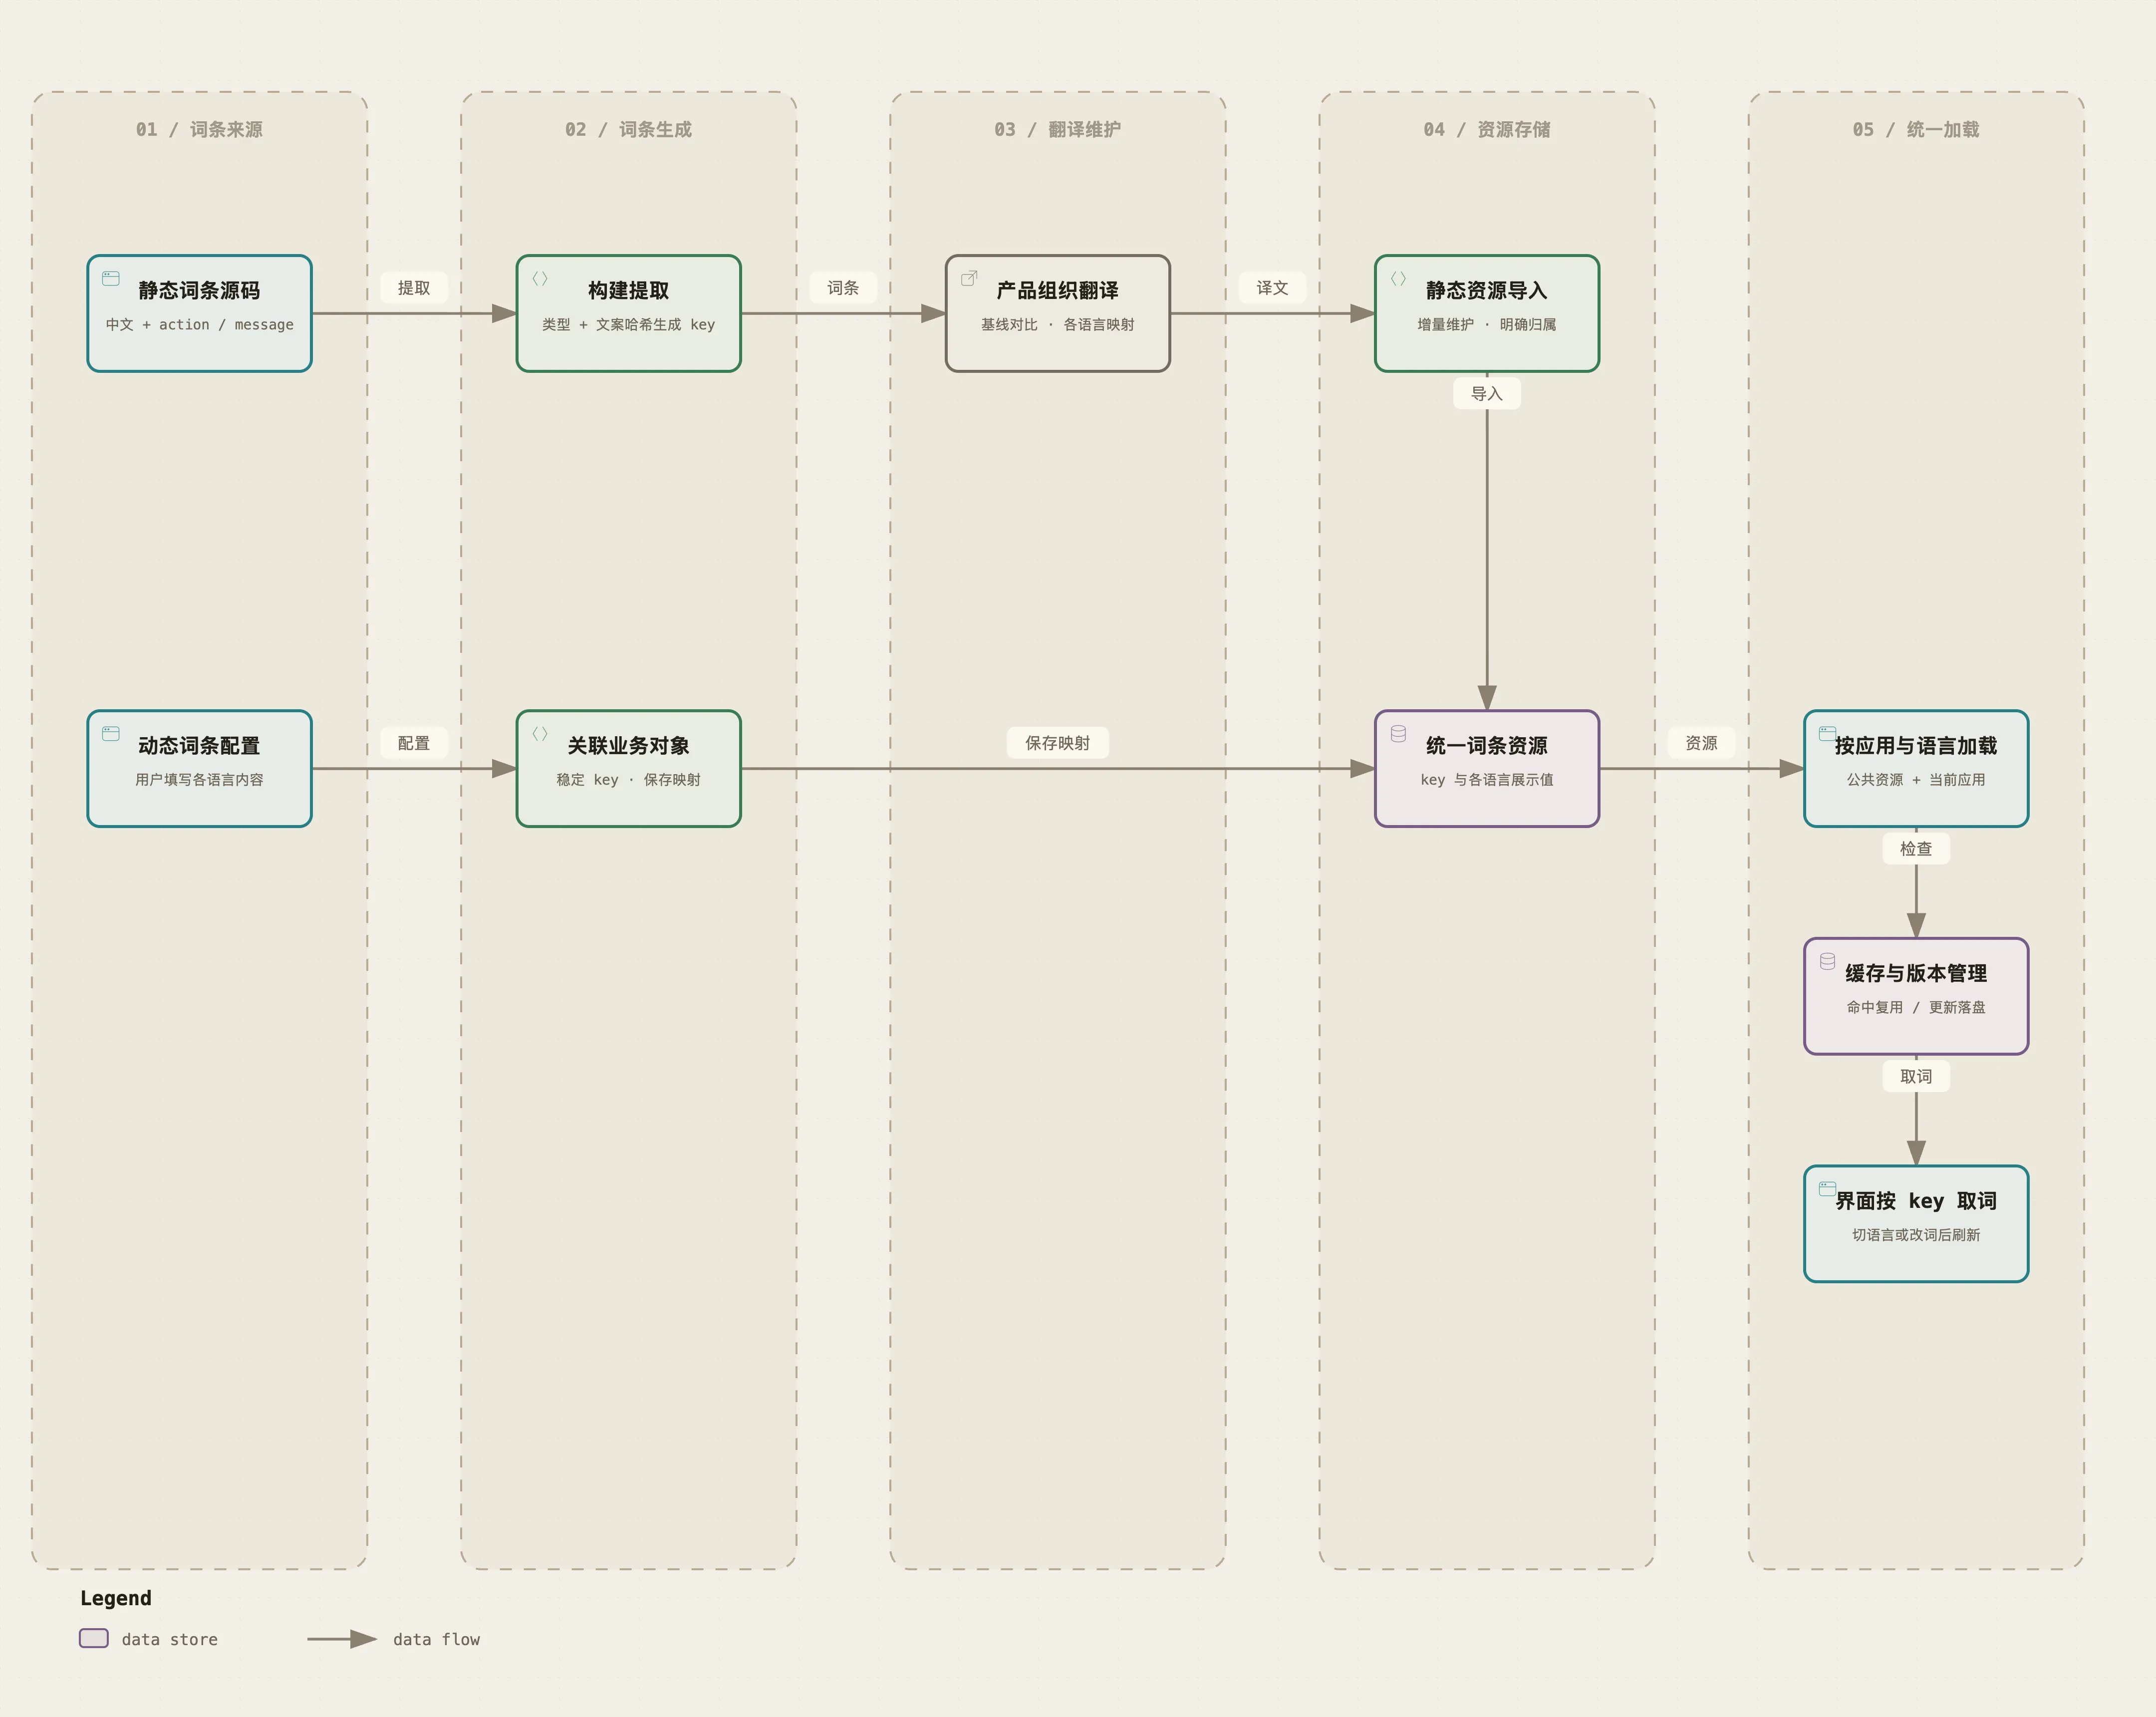
完整流程如下。上方是静态词条支路:源码保留中文和使用类型,构建时提取,再由产品组织翻译并导入。下方是动态词条支路:用户通过界面配置各语言内容,关联业务对象的稳定 key 后保存,不经过源码提取。两条支路汇入统一词条资源,再按应用与语言加载,通过缓存和版本管理更新资源,交给界面按 key 取词。
你要请我喝一杯奶茶?
版权声明:自由转载-非商用-保持署名和原文链接。
本站文章均为本人原创,参考文章我都会在文中进行声明,也请您转载时附上署名。